Régularisation & optimisation
La dernière fois...
Notions
- Notre premier modèle de deep learning : le perceptron multi-couche
- Permet de calculer une sortie pour une entrée donnée
- Évaluation d'un modèle avec une fonction de coût
- Permet de dire si la sortie du modèle est loin de la réalité suivant une métrique
- Une méthodologie pour optimiser la fonction de coût : la descente de gradient (stochastique)
- Un algorithme pour calculer les gradients : la back propagation
Ce que nous allons voir aujourd’hui
Objectif. Comprendre comment faire généraliser un réseau et accélérer / fiabiliser son entraînement.
- Cadre d’évaluation : train / val / test, pièges (temporel, contextuel)
- Diagnostiquer sur-apprentissage vs sous-apprentissage
- Métriques : matrice de confusion, précision, rappel, F1, ROC-AUC, évaluation humaine
Ce que nous allons voir aujourd’hui
- Régularisation : pénalités L2/L1
- Optimisation : paysage de la loss, SGD, Momentum, Adagrad, RMSProp, Adam, learning rate & batch
- En pratique : checklist & petites démos
Schéma
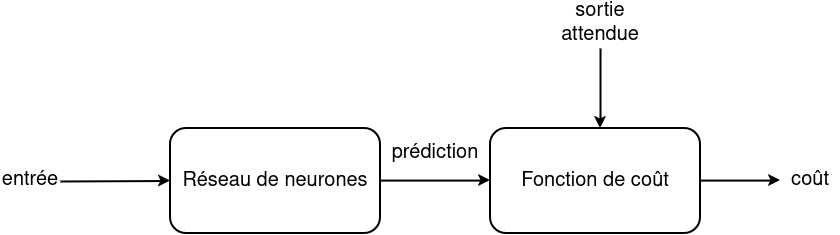
Est-ce que la fonction de coût garantie la qualité ?
- La fonction de coût n'est pas nécessairement corrélée à 100% à notre objectif business
- On va rarement nous demander de réduire la RMSE ou l'entropie croisée de nos clients
- Cependant, la vraie fonction objectif n'est pas souvent utilisable en pratique : trop longue à calculer, demande l'annotation d'humaine, pas différentiable, pas de définition mathématique claire...
Est-ce que la fonction de coût garantie la qualité ?
- Une valeur faible sur un jeu de données ne veut pas forcément dire qu'elle sera faible sur un autre jeu de données
- On aimerait que notre réseau de neurone se généralise
- Il va falloir utiliser un jeu d'entraînement, de validation et de test
Ce que nous voulons réellement mesurer, c’est la performance hors échantillon (dev/test), pas seulement la baisse du loss sur le train.
Procédure d'entraînement et d'évaluation classique
Algorithme
- Partage de notre dataset en sous ensembles d'entraînement (train), de validation (val) et de test (test)
- Tant que !(condition d’arrêt) — ex. early stopping sur la perte val (patience = 5), ou nombre d’epochs max
- Entraîner le réseau sur le train (en général 1 epoch, ou X itérations)
- Évaluation sur le val (coût + autres métriques automatiques)
- Évaluation sur le train (coût + autres métriques automatiques)
- Évaluation sur le test (coût + autres métriques automatiques + humains)
Train/Val/Test
- Généralement, on partage (split) aléatoirement notre dataset en trois sous-groupes train/val/test contenant 80%/10%/10% des données
- Peut varier suivant la taille des données, on veut que l'évaluation soit suffisamment rapide tout en étant précise
- On peut descendre à <1% pour le dev et test pour les très gros jeux de données
- Si l'on compare plusieurs baselines, bien utiliser les mêmes train/val/test
- Bien s'assurer qu'il n'y ait pas de données communes entre les sous-groupes (valeur dupliquée par exemple)
Train/Val/Test
- Dans certains cas, le split ne doit pas être aléatoire
- Données temporelles : split par ordre chronologique
- val/test sur une nouveauté retrouvée en pratique : nouvelle personne, nouvel arrière-plan, ...
- Essayer d'avoir un dev et un test similaires
Fuite de données (Data Leakage)
La fuite de données survient lorsque des informations du jeu de validation ou de test se retrouvent accidentellement utilisées lors de l'entraînement.
Exemples classiques :
- Fuite de prétraitement : Calculer la moyenne et la variance pour normaliser les données sur l'ensemble du dataset avant de faire le split. (Solution : calculer uniquement sur le train).
- Fuite d'identifiant : Un même patient/client apparaît à la fois dans le train et dans le test avec des relevés différents.
- Fuite temporelle : Utiliser des données du futur pour prédire un événement du passé.
Conséquence : Les performances en validation semblent excellentes, mais le modèle échouera lamentablement en production.
Validation Croisée (K-Fold)
Lorsque le jeu de données est petit, un split 80/10/10 peut produire une évaluation très bruitée (trop dépendante du tirage aléatoire).
La validation croisée à K plis (K-Fold Cross-Validation) consiste à :
- Diviser le dataset en K sous-ensembles (folds) de taille égale.
- Entraîner le modèle K fois : à chaque itération, K-1 plis servent pour l'entraînement, et le pli restant sert de validation.
- Faire la moyenne des performances obtenues sur les K itérations.
Remarque en Deep Learning : L'entraînement d'un réseau de neurones étant coûteux en calcul, le K-Fold est plus rare en deep learning que sur les modèles classiques de machine learning. On se contente souvent d'un split statique (Hold-out) sur les grands jeux de données.
Découpage temporel
Idée clé : la chronologie prime, on évalue sur du futur, pas sur du “mélangé”.
# Données complètes
X = torch.arange(-5, 5, 0.05)
Y = X + 3 * torch.sin(5 * X)
fig = px.scatter(
x=X, y=Y,
title="Données complètes (régression jouet)",
labels={"x": "x", "y": "y"}
)
fig.update_traces(marker_size=5, opacity=0.7)
fig.update_layout(margin=dict(l=20, r=20, t=50, b=20))
fig.show()
# Split aléatoire : 80% train / 20% test = Trop Facile
X = torch.arange(-5, 5, 0.05)
Y = X + 3 * torch.sin(5 * X)
perm = torch.randperm(len(X))
split = int(0.8 * len(X))
train_idx, test_idx = perm[:split], perm[split:]
fig = go.Figure(data=[
go.Scatter(x=X[train_idx], y=Y[train_idx], mode="markers", name="train"),
go.Scatter(x=X[test_idx], y=Y[test_idx], mode="markers", name="test"),
])
fig.update_layout(
title="Split aléatoire naïf = trop facile",
xaxis_title="x", yaxis_title="y",
legend_title_text="Jeu"
)
fig.show()
# Un découpage temporel permet de mieux valider la généralisabilité
X = torch.arange(-5, 5, 0.05)
Y = X + 3 * torch.sin(5 * X)
cut = int(0.8 * len(X))
train_idx = torch.arange(0, cut)
test_idx = torch.arange(cut, len(X))
fig = go.Figure(data=[
go.Scatter(x=X[train_idx], y=Y[train_idx], mode="markers", name="train"),
go.Scatter(x=X[test_idx], y=Y[test_idx], mode="markers", name="test"),
])
fig.add_vline(x=float(X[cut]), line_dash="dash", annotation_text="frontière temporelle", annotation_position="top")
fig.update_layout(
title="Découpage temporel (mieux pour valider la généralisation)",
xaxis_title="x", yaxis_title="y", legend_title_text="Jeu"
)
fig.show()
Découpage contextuel
- Compétition "The Nature Conservancy Fisheries Monitoring" : identifier automatiquement des poissons.
- Très bons scores en validation interne, forte chute sur le test final.
- Raison : le test final contient de nouveaux bateaux → les modèles avaient appris l’arrière-plan (bateau ↔ type de poisson), pas le poisson.

Découpage contextuel
- Compétition "State Farm Distracted Driver Detection" : classifier des conducteurs distraits.
- Chute sur test final car le test introduit de nouvelles personnes.
- Le split de validation doit éviter que la même personne soit à la fois en train et en val/test.

- Outils pratiques : GroupKFold / GroupShuffleSplit (scikit-learn) quand plusieurs échantillons partagent un groupe (utilisateur, appareil, bateau…).
Évaluation
- Le loss (train/val) donne une approximation du progrès d'entraînement, pas la performance métier.
- On choisit des métriques alignées avec l'objectif :
- Classification : Accuracy (⚠️ classes déséquilibrées), Précision, Rappel, F1, ROC-AUC, PR-AUC.
- Régression : MAE, RMSE, $R^2$, médiane des erreurs (robuste aux outliers).
- Cas ambigus / objectifs qualitatifs : prévoir une évaluation humaine (jury, guidelines, double-annotation).
Règle d'or : On ne touche jamais au test final pendant le dev. Le seuil (0.5→autre) se choisit sur validation.
Matrice de confusion
On compte dans une matrice le nombre d'occurrences des couples (prédiction, valeur vraie).
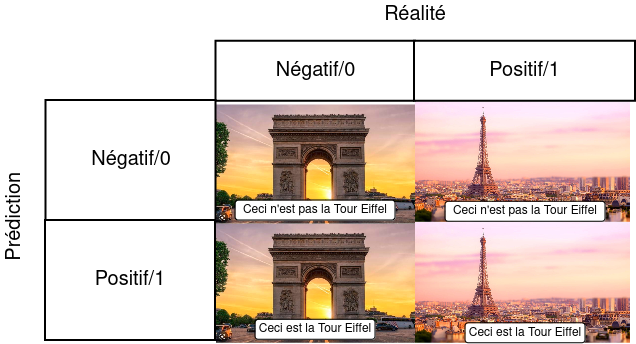
Convention utilisée ici : colonnes = vérité, lignes = prédiction. Inversé dans sklean.
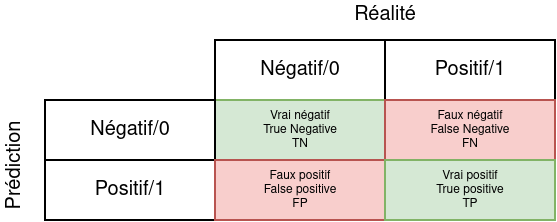
Matrice de confusion - Exemple
Métrique : Accuracy
L'accuracy correspond au taux de prédictions correctes
$$accuracy = \frac{TP + TN}{TP + TN + FP + FN}$$
⚠️ Déséquilibre : si 99% de négatifs, prédire “négatif” tout le temps donne 99% d'accuracy mais 0 rappel sur la classe positive.
→ Toujours regarder Précision/Rappel/F1 (et PR-AUC) quand les classes sont déséquilibrées.
Métrique : Précision
La précision est la part de prédictions positives qui sont correctes.
$$\text{precision} = \frac{TP}{TP + FP}$$
À privilégier quand les faux positifs coûtent cher (ex. déclencher une action onéreuse, alerter un client, investir). Exemples :
- Détection d'opportunité trading : on préfère peu d'alertes mais fiables.
- Système d’alerte “intervention technicien” : mieux vaut être sûr avant d’envoyer quelqu’un.
Seuil ≠ 0.5 : on peut exiger une précision cible (ex. 95%) en relevant le seuil, au prix d’un rappel plus faible.
Remarque : On peut se permettre de dire "je ne sais pas" en faisant une prédiction négative et répondre à peu de prédictions positivement pour avoir un très bon score.
Métrique : Rappel
Le rappel mesure la proportion d'éléments réellement positifs qui ont été correctement identifiés par le modèle
$$rappel = \frac{TP}{TP + FN}$$
Cette métrique se concentre sur le fait de détecter toutes les occurrences positives, quitte à faire des erreurs sur les négatives.
Quand le rappel est prioritaire :
- Détection d'anomalies critiques (sécurité industrielle)
- Dépistage médical (mieux vaut ne pas rater un positif)
Remarque : Pour avoir un score parfait, il suffit de tout prédire en positif.
Métrique : F1
Le score F1 est un compromis entre la précision et le rappel
$$F1 = \frac{precision \times rappel}{precision + rappel}$$
Il permet d'éviter les cas très faciles pour la précision et le rappel.
$F_\beta$ généralise : $\beta>1$ favorise le rappel, $\beta<1$ la précision.
Métrique : Multiclasse
- macro : moyenne simple des classes (équilibre l'attention)
- weighted : pondérée par le support (utile si classes déséquilibrées)
- micro : agrège TP/FP/FN globaux (pertinent si tailles de classes très différentes)
Métrique : Courbe ROC
La courbe ROC consiste à tracer le taux de vrai positif en fonction du taux de faux positifs (parfois, on trace aussi la précision en fonction du rappel, la courbe PR).
Pour en extraire une métrique, on prend l'aire sous la courbe (AUC = Area Under the Curve) : plus elle est grande, meilleur est le modèle.
Remarque : Comment faire varier TP et FP ? On peut jouer sur la valeur de seuil, usuellement à 0.5.
ROC vs PR : si la classe positive est rare, préférez aussi la courbe PR et la PR-AUC (plus sensible à la qualité des positifs).
fig = px.area(x=[0, 1], y=[0, 1])
fig.update_layout(xaxis_title='FPR', yaxis_title='TPR', title="ROC — Classificateur aléatoire (AUC = 0.5)")
fig.show()
En-dessous de l’aléatoire → souvent étiquettes inversées, fuite de données, ou score au signe inversé.
Inverser peut “sauver” la perf, mais vérifier d’abord les données.
fig = px.area(x=[0, 1], y=[1, 1])
fig.update_layout(xaxis_title='FPR', yaxis_title='TPR', title="Classificateur parfait")
fig.show()
fig = px.area(x=[0, 0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9, 1.0],
y=[0.1, 0.32, 0.40, 0.45, 0.7, 0.81, 0.89, 0.93, 0.94, 0.98, 1.0])
fig.update_layout(xaxis_title='FPR', yaxis_title='TPR', title="Cas général")
fig.show()
Évaluation humaine
Pour être sûr de notre évaluation, la manière la plus simple et efficace est de demander à des humains d'annoter les résultats.
Il y a des nombreuses manières de faire l'annotation, par exemple une annotation binaire (vrai/faux) ou multi-critère (dire pourquoi c'est faux).
Même dans ce cas, il se peut que les humains ne soient pas d'accord sur l'annotation. On demande alors à plusieurs humains d'annoter la même prédiction et on utilise un score d'accord (ex: le kappa de Cohen).
Mini-protocole d’évaluation humaine
- Échantillon : tirer aléatoirement N exemples par classe (stratifié)
- Consignes : critères clairs + exemples limites (3–5 min)
- Double annotation (2 annotateurs) → calculer accord (Cohen’s κ)
- Arbitrage : un 3ᵉ annotateur tranche les désaccords
- Rapport : inclure % erreurs acceptables (tolérance métier)
⚠️ Sélectionnez les exemples à l’aveugle (pas “les pires” cas), et geler le protocole avant de regarder les résultats.
Choix des hyperparamètres
Les hyperparamètres sont des paramètres de notre système qui ne sont pas appris mais décidés par un humain.
Exemples : learning rate, nombre de couches et de neurones, ...
On les trouve en essayant plusieurs combinaisons et en comparant les performances sur le jeu de validation (et pas de test !).
On peut réutiliser les techniques vues en machine learning : random search, grid search
Surapprentissage
Le surapprentissage (ou overfitting) est un phénomène qui se traduit par de bonnes performances sur le jeu d'entraînement, mais par des performances dégradées sur des valeurs non vues (par exemple, le jeu de validation ou de test).
Remarque : Si l'on fait beaucoup d'expériences pour trouver des hyperparamètres, il est possible de finir par overfit sur le jeu de validation !
# Régression 1D : overfit (relier les points)
X = torch.arange(-2, 2, 0.1)
Y_true = X**2
# "train" échantillonné + bruit
idx = torch.arange(0, len(X), 3)
X_train = X[idx]
Y_train = Y_true[idx] + (torch.rand(len(idx)) - 0.5) / 2
fig = go.Figure([
go.Scatter(x=X_train, y=Y_train, mode="markers", name="train (bruité)"),
# "overfit" = relier exactement les points de train
go.Scatter(x=X_train, y=Y_train, mode="lines", name="surajusté (relie les points)")
])
fig.update_layout(
title="Régression — Courbe qui colle au bruit = overfit",
xaxis_title="x", yaxis_title="y", legend_title_text=""
)
fig.show()
X = torch.arange(-2, 2, 0.1)
Y_true = X**2
idx = torch.arange(0, len(X), 3)
X_train = X[idx]
Y_train = Y_true[idx] + (torch.rand(len(idx)) - 0.5) / 2
fig = go.Figure([
go.Scatter(x=X_train, y=Y_train, mode="markers", name="train (bruité)"),
go.Scatter(x=X, y=Y_true, mode="lines", name="modèle lisse (≈ vraie fonction)")
])
fig.update_layout(
title="Régression — Modèle plus généralisable (ne colle pas au bruit)",
xaxis_title="x", yaxis_title="y", legend_title_text=""
)
fig.show()
X = torch.arange(-1, 1, 0.01)
Y = torch.sigmoid(100*X)
X_test = [-0.9, -0.8, -0.75, -0.7, -0.68, -0.61, -0.59, -0.54, 0.53, 0.60, 0.69, 0.71, 0.74, 0.76, 0.79, 0.84]
Y_test = [0, 0, 0, 0, 0, 0, 0, 0, 1, 1, 1, 1, 1, 1, 1, 1]
fig = go.Figure([
go.Scatter(x=X_test, y=Y_test, mode="markers", marker_color="red", name="dataset"),
go.Scatter(x=X, y=Y, mode="lines", line_color="blue", name="Modèle")
])
fig.add_vrect(x0="-0.5", x1="0.5",
annotation_text="Pas de données", annotation_position="top left",
fillcolor="red", opacity=0.25, line_width=0)
fig.update_layout(title="Modèle de classification trop confiant dans une zone sans donnée")
fig.add_hline(y=0.5, line_dash="dot", annotation_text="seuil 0.5", annotation_position="right")
fig.update_layout(xaxis_title="x", yaxis_title="P(y=1)")
fig.show()
X = torch.arange(-1, 1, 0.01)
Y = torch.sigmoid(10*X)
X_test = [-0.9, -0.8, -0.75, -0.7, -0.68, -0.61, -0.59, -0.54, 0.53, 0.60, 0.69, 0.71, 0.74, 0.76, 0.79, 0.84]
Y_test = [0, 0, 0, 0, 0, 0, 0, 0, 1, 1, 1, 1, 1, 1, 1, 1]
fig = go.Figure([
go.Scatter(x=X_test, y=Y_test, mode="markers", marker_color="red", name="dataset"),
go.Scatter(x=X, y=Y, mode="lines", line_color="blue", name="Modèle")
])
fig.add_vrect(x0="-0.5", x1="0.5",
annotation_text="Pas de données", annotation_position="top left",
fillcolor="red", opacity=0.25, line_width=0)
fig.update_layout(title="Modèle de classification sûrement plus généralisable",
xaxis_title="x", yaxis_title="P(y=1)")
fig.add_hline(y=0.5, line_dash="dot", annotation_text="seuil 0.5", annotation_position="right")
fig.show()
Comment détecter un surapprentissage ?
Sur les métriques finales, comparez vos métriques entre le train et le dev.
- Si train >> dev => overfit
- Si train > dev => ok ou overfit
- Si train ~ dev => ok ou underfit ou dev trop simple
- Si dev >> train => Votre dev a un problème (trop facile)
Comment détecter un surapprentissage ?
Sur les courbes d'apprentissage, comparez train vs validation (pour une métrique à maximiser ; pour une loss, inverser le raisonnement).
| Train ↑/↓ | Val ↑/↓ | Lecture rapide |
|---|---|---|
| ↑ | ↓ | Overfit (le modèle mémorise) |
| ↓ | ↓ | Underfit (modèle trop simple / mauvais features) |
| ↑ | ↑ | OK (ou fuite si val est trop facile) |
| ↓ | ↑ | Cas rare → vérifier données/splits |
Indices visuels : écart train–val qui se creuse, val qui remonte alors que train continue de baisser.
Sous-apprentissage / Underfit
Le sous-apprentissage est un phénomène qui apparaît quand les performances du modèles ne sont pas "suffisamment bonnes", c'est-à-dire que l'apprentissage n'est pas terminé ou le modèle n'est pas assez complexe ou est incorrectement paramétré.
Causes fréquentes
- Modèle trop simple / régularisation trop forte
- Pas assez d'epochs / LR trop faible
- Features insuffisantes ou cibles très bruitées
X = torch.arange(-2, 2, 0.1)
Y = X * 0 + 0.5
X_test = torch.Tensor([-1, -0.8, -0.4, 0.1, 0.2, 0.3, 0.7, 1.1])
Y_test = X_test * X_test + (torch.rand(len(X_test)) - 0.5) / 2 # On ajoute du bruit
fig = go.Figure([
go.Scatter(x=X_test, y=Y_test, mode="markers", marker_color="red", name="dataset"),
go.Scatter(x=X, y=Y, mode="lines", line_color="blue", name="Modèle")
])
fig.update_layout(
title="Sous-apprentissage — Modèle constant (trop simple)",
xaxis_title="x", yaxis_title="y", legend_title_text=""
)
fig.show()
Comment détecter un sous-apprentissage ?
Il faut définir ce que signifie des performances "suffisamment bonnes". Souvent, cela signifie des performances comparables à un humain.
On peut donc faire annoter des données en entrée par des humains pour qu'ils nous donnent la sortie. Ensuite, on calcule les performances des humains (souvent pas 100% pour des tâches un peu complexes).
- Si erreur sur train et dev >> erreur humaine => underfit
- Si erreur sur train et dev ~ erreur humaine => ok
- Si erreur sur train et dev << erreur humaine => Fantastique !
Comment détecter un sous-apprentissage ?
Checks rapides
- Augmentez légèrement la capacité (plus de neurones / moins de régularisation) → la val monte ? (alors vous étiez sous-ajusté)
- Laissez plus d'epochs → la val monte puis redescend ?
Réduire le sur-apprentissage avec la régularisation
Idée clé. On contraint le modèle pour améliorer la généralisation (au prix d’un peu d’erreur train).
Ce que nous voyons maintenant :
- Régularisation L2 et L1 (intuitions, effets)
- Gradient avec L2 et lien avec weight decay
- Où l’appliquer
Qu'est-ce que la régularisation ?
La régularisation est un ensemble de techniques pénalisant la complexité afin réduire les erreurs de généralisation (overfit sur le dev et test) en ayant le moins d'impact possible sur l'erreur d'entraînement (sur le train).
Contraindre les poids par la fonction de coût
Une première méthode pour contrôler la généralisabilité consiste à imposer des contraintes sur les poids. Elles peuvent s'intégrer directement dans la fonction de coût.
$$J(W) = \frac{1}{n} \sum_{i=1}^n \mathcal{L}(f(x^{(i)}; W), y^{(i)}) + \lambda \cdot R(W)$$
où $\lambda$ est un hyperparamètre donnant plus ou moins d'importance à la régularisation et $R(W)$ est une fonction pénalisant les poids dans certaines configurations.
Fonctions de régularisation classiques
- L2 : $R(W)=\lVert W\rVert_2^2=\sum_{i,j} W_{i,j}^2$ — rétrécit les poids (peu de 0 exacts), lisse
- L1 : $R(W)=\lVert W\rVert_1=\sum_{i,j} \lvert W_{i,j}\rvert$ — favorise la sparsité (zéros)
- Elastic Net : $\lambda_1 \lVert W\rVert_1 + \lambda_2 \lVert W\rVert_2^2$ — compromis L1/L2
Exemples
Soit $x = [1,1,1,1]^T$.
$w_1 = [1, 0, 0, 0]^T$
$\lVert w_1\rVert_2^2 = 1,\ \lVert w_1\rVert_1 = 1,\ w_1^T x = 1$$w_2 = [0.25, 0.25, 0.25, 0.25]^T$
$\lVert w_2\rVert_2^2 = 4\times 0.25^2 = 0.25,\ \lVert w_2\rVert_1 = 1,\ w_2^T x = 1$$w_3 = [4, -1, -1, -1]^T$
$\lVert w_3\rVert_2^2 = 16+1+1+1 = 19,\ \lVert w_3\rVert_1 = 7,\ w_3^T x = 1$
Lecture. Même sortie ($w^T x = 1$), mais pénalités très différentes : L2 préfère $w_2$, L1 aime la sparsité de $w_1$.
Gradient de la régularisation L2
$$ J_{\text{reg}}(W)=J(W)+\lambda \lVert W\rVert_2^2 \quad\Rightarrow\quad \nabla J_{\text{reg}}(W)=\nabla J(W)+2\lambda W $$
Mise à jour descente de gradient : $$ W_{t+1} = W_t - \eta\big(\nabla J(W_t) + 2\lambda W_t\big) = (1 - 2\eta\lambda)\,W_t\;-\;\eta\,\nabla J(W_t) $$
Posons $\alpha = 2\eta\lambda$ : $W_{t+1}=(1-\alpha)W_t - \eta\,\nabla J(W_t)$
Weight decay
Le weight decay consiste à retirer un peu de $W_t$ à chaque mise à jour, ce qui est équivalent à une régularisation L2 pour des optimisateurs simples.
Remarque : Souvent, vous verrez mentionné le weight decay dans les arguments de l'optimisateur. Dans ce cas, ce n'est pas la peine de rajouter de la régularisation L2.
Optimisation avancée
Objectif : converger plus vite et plus sûrement.
Nous verrons :
- Momentum (inertie)
- Adagrad (normalisation adaptative)
- RMSProp (poids récents)
- Adam (Momentum + adaptatif)
Problèmes avec la descente de gradient stochastique
- Convergence lente quand la pente est grande suivant une direction et petite suivant une autre.
- Le gradient fait de grands aller-retours dans un cas, et de petits sauts dans l'autre
- Reste bloqué dans des minima locaux et des points selle
- Le gradient y est nul
- Mauvais conditionnement (vallées étroites) → zig-zag et convergence lente
- L'aspect stochastique crée du bruit
def show_sgd():
X = torch.arange(-2, 2, 0.1)
Y = torch.arange(-2, 2, 0.1)
Z = []
for x in X:
temp = []
for y in Y:
temp.append(10 * x * x + y * y)
Z.append(temp)
Z = torch.Tensor(Z)
X_descent, Y_descent, Z_descent = [-1.5], [-1.5], [11 * 1.5 * 1.5]
lr = 0.095
for _ in range(10):
X_descent.append(X_descent[-1] - lr * 2 * 10 * X_descent[-1])
Y_descent.append(Y_descent[-1] - lr * 2 * Y_descent[-1])
Z_descent.append(10 * X_descent[-1] * X_descent[-1] + Y_descent[-1] * Y_descent[-1])
fig = go.Figure(data=[
go.Surface(z=Z.T, x=X, y=Y)
])
fig.update_traces(
contours_z=dict(show=True, usecolormap=True, highlightcolor="limegreen", project_z=True))
fig.update_layout(
title="SGD sur surface anisotrope : zig-zag (10·w1² + w2²)",
scene=dict(
xaxis_title="w1", yaxis_title="w2", zaxis_title="J(w1,w2)",
camera=dict(eye=dict(x=1.6, y=1.6, z=0.9))
),
margin=dict(l=0, r=0, b=0, t=40)
)
fig.add_trace(
go.Scatter3d(x=X_descent, y=Y_descent, z=Z_descent, marker_color="red"))
fig.show()
fig2 = go.Figure()
fig2.add_trace(go.Contour(
x=X, y=Y, z=Z.T.numpy(), contours_coloring="lines", showscale=False, name="niveaux J"))
fig2.add_trace(go.Scatter(x=X_descent, y=Y_descent, mode="markers+lines", name="trajectoire SGD"))
fig2.update_layout(title="Projection 2D — Trajectoire de SGD", xaxis_title="w1", yaxis_title="w2")
fig2.show()
show_sgd()
def show_local_minimum():
x = torch.arange(-2, 2, 0.01)
t = -2
t_descent = [t]
y_descent = [2.0 - 1 * t - 2 * t ** 2 + 0.16 * t ** 3 + 0.5 * t**4]
lr = 0.2
for _ in range(10):
t = t_descent[-1]
grad = -1 - 4 * t + 0.16 * 3 * t ** 2 + 2 * t ** 3
t = t - lr * grad
t_descent.append(t)
y_descent.append(2.0 - 1 * t - 2 * t ** 2 + 0.16 * t ** 3 + 0.5 * t**4)
fig = go.Figure([
go.Scatter(x=x, y=2.0 - 1 * x - 2 * x ** 2 + 0.16 * x ** 3 + 0.5 * x**4, name="fonction"),
go.Scatter(x=t_descent, y=y_descent, mode="lines+markers", marker=dict(size=10, color="red"), name="valeur")
])
fig.show()
show_local_minimum()
import torch, numpy as np
import plotly.graph_objects as go
def show_local_minimum(lr=0.05, iters=80, x0=(1.5, 1.0), seed=0, with_momentum=False, beta=0.9):
torch.manual_seed(seed)
# Paysage non convexe : "vallées" + minima locaux
def f(x, y):
# double puits + terme quadratique léger
return (x**2 + y**2) + 3*torch.sin(2*x)*torch.cos(2*y)
def grad(x, y):
df_dx = 2*x + 3*2*torch.cos(2*x)*torch.cos(2*y)
df_dy = 2*y - 3*2*torch.sin(2*x)*torch.sin(2*y)
return torch.stack([df_dx, df_dy], dim=-1)
# grille pour contours
gx = torch.linspace(-3, 3, 200)
gy = torch.linspace(-3, 3, 200)
XX, YY = torch.meshgrid(gx, gy, indexing="xy")
ZZ = f(XX, YY)
# descente
xy = torch.tensor(x0, dtype=torch.float32)
traj = [xy.clone()]
v = torch.zeros_like(xy)
for _ in range(iters):
g = grad(xy[0], xy[1]).squeeze()
# print(xy, f(xy[0], xy[1]))
if with_momentum:
v = beta*v + (1-beta)*g
xy = xy - lr * v
else:
xy = xy - lr * g
traj.append(xy.clone())
traj = torch.stack(traj)
Xd, Yd = traj[:,0].numpy(), traj[:,1].numpy()
# plot
fig = go.Figure()
fig.add_trace(go.Contour(x=gx.numpy(), y=gy.numpy(), z=ZZ.numpy().T,
contours_coloring="lines", showscale=False, name="niveaux J"))
fig.add_trace(go.Scatter(x=Xd, y=Yd, mode="markers+lines", name="trajectoire"))
fig.add_trace(go.Scatter(x=[x0[0]], y=[x0[1]], mode="markers", name="départ", marker_symbol="x", marker_size=12))
fig.update_layout(
title=f"Descente {'avec momentum' if with_momentum else 'SGD'} — f(x,y)=(x²+y²)+3·sin(2x)·cos(2y)",
xaxis_title="x", yaxis_title="y", legend_title_text=""
)
fig.show()
show_local_minimum(lr=0.01)
# Plusieurs redémarrages pour voir les minima atteints
starts = [(1.5, 1.0), (-2.0, 1.2), (0.5, -2.5), (2.2, -0.8)]
for i, s in enumerate(starts):
show_local_minimum(lr=0.05, iters=80, x0=s, seed=i)
tensor([1.5000, 1.0000]) tensor(3.0738) tensor([1.2264, 0.9385]) tensor(1.8101) tensor([1.0340, 1.0265]) tensor(0.9001) tensor([0.8642, 1.1574]) tensor(0.0798) tensor([0.7459, 1.2597]) tensor(-0.2870) tensor([0.6905, 1.3080]) tensor(-0.3608) tensor([0.6704, 1.3250]) tensor(-0.3700) tensor([0.6637, 1.3304]) tensor(-0.3710) tensor([0.6614, 1.3320]) tensor(-0.3711) tensor([0.6607, 1.3325]) tensor(-0.3711) tensor([0.6604, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711) tensor([0.6603, 1.3326]) tensor(-0.3711)
tensor([-2.0000, 1.2000]) tensor(3.7658) tensor([-1.9446, 1.2334]) tensor(3.7101) tensor([-1.9219, 1.2375]) tensor(3.7022) tensor([-1.9097, 1.2335]) tensor(3.6993) tensor([-1.9012, 1.2277]) tensor(3.6973) tensor([-1.8943, 1.2216]) tensor(3.6957) tensor([-1.8882, 1.2157]) tensor(3.6943) tensor([-1.8826, 1.2101]) tensor(3.6930) tensor([-1.8772, 1.2048]) tensor(3.6919) tensor([-1.8720, 1.1996]) tensor(3.6909) tensor([-1.8670, 1.1946]) tensor(3.6899) tensor([-1.8620, 1.1896]) tensor(3.6889) tensor([-1.8570, 1.1846]) tensor(3.6878) tensor([-1.8519, 1.1795]) tensor(3.6868) tensor([-1.8467, 1.1743]) tensor(3.6857) tensor([-1.8413, 1.1689]) tensor(3.6845) tensor([-1.8357, 1.1633]) tensor(3.6832) tensor([-1.8296, 1.1573]) tensor(3.6817) tensor([-1.8232, 1.1508]) tensor(3.6800) tensor([-1.8161, 1.1438]) tensor(3.6779) tensor([-1.8083, 1.1360]) tensor(3.6753) tensor([-1.7996, 1.1272]) tensor(3.6720) tensor([-1.7896, 1.1173]) tensor(3.6677) tensor([-1.7781, 1.1057]) tensor(3.6619) tensor([-1.7644, 1.0920]) tensor(3.6536) tensor([-1.7478, 1.0754]) tensor(3.6414) tensor([-1.7272, 1.0549]) tensor(3.6222) tensor([-1.7010, 1.0286]) tensor(3.5904) tensor([-1.6664, 0.9941]) tensor(3.5340) tensor([-1.6192, 0.9468]) tensor(3.4262) tensor([-1.5520, 0.8796]) tensor(3.2035) tensor([-1.4529, 0.7805]) tensor(2.7134) tensor([-1.3048, 0.6324]) tensor(1.6441) tensor([-1.0964, 0.4241]) tensor(-0.2304) tensor([-0.8712, 0.1988]) tensor(-1.9269) tensor([-0.7368, 0.0645]) tensor(-2.4140) tensor([-0.6920, 0.0196]) tensor(-2.4663) tensor([-0.6785, 0.0061]) tensor(-2.4711) tensor([-0.6743, 0.0019]) tensor(-2.4715) tensor([-6.7298e-01, 6.0190e-04]) tensor(-2.4716) tensor([-6.7257e-01, 1.8966e-04]) tensor(-2.4716) tensor([-6.7244e-01, 5.9783e-05]) tensor(-2.4716) tensor([-6.7239e-01, 1.8847e-05]) tensor(-2.4716) tensor([-6.7238e-01, 5.9415e-06]) tensor(-2.4716) tensor([-6.7238e-01, 1.8731e-06]) tensor(-2.4716) tensor([-6.7238e-01, 5.9053e-07]) tensor(-2.4716) tensor([-6.7238e-01, 1.8617e-07]) tensor(-2.4716) tensor([-6.7238e-01, 5.8694e-08]) tensor(-2.4716) tensor([-6.7238e-01, 1.8504e-08]) tensor(-2.4716) tensor([-6.7238e-01, 5.8336e-09]) tensor(-2.4716) tensor([-6.7238e-01, 1.8391e-09]) tensor(-2.4716) tensor([-6.7238e-01, 5.7981e-10]) tensor(-2.4716) tensor([-6.7238e-01, 1.8279e-10]) tensor(-2.4716) tensor([-6.7238e-01, 5.7628e-11]) tensor(-2.4716) tensor([-6.7238e-01, 1.8168e-11]) tensor(-2.4716) tensor([-6.7238e-01, 5.7277e-12]) tensor(-2.4716) tensor([-6.7238e-01, 1.8058e-12]) tensor(-2.4716) tensor([-6.7238e-01, 5.6929e-13]) tensor(-2.4716) tensor([-6.7238e-01, 1.7948e-13]) tensor(-2.4716) tensor([-6.7238e-01, 5.6582e-14]) tensor(-2.4716) tensor([-6.7238e-01, 1.7838e-14]) tensor(-2.4716) tensor([-6.7238e-01, 5.6238e-15]) tensor(-2.4716) tensor([-6.7238e-01, 1.7730e-15]) tensor(-2.4716) tensor([-6.7238e-01, 5.5895e-16]) tensor(-2.4716) tensor([-6.7238e-01, 1.7622e-16]) tensor(-2.4716) tensor([-6.7238e-01, 5.5555e-17]) tensor(-2.4716) tensor([-6.7238e-01, 1.7515e-17]) tensor(-2.4716) tensor([-6.7238e-01, 5.5217e-18]) tensor(-2.4716) tensor([-6.7238e-01, 1.7408e-18]) tensor(-2.4716) tensor([-6.7238e-01, 5.4881e-19]) tensor(-2.4716) tensor([-6.7238e-01, 1.7302e-19]) tensor(-2.4716) tensor([-6.7238e-01, 5.4547e-20]) tensor(-2.4716) tensor([-6.7238e-01, 1.7197e-20]) tensor(-2.4716) tensor([-6.7238e-01, 5.4215e-21]) tensor(-2.4716) tensor([-6.7238e-01, 1.7092e-21]) tensor(-2.4716) tensor([-6.7238e-01, 5.3885e-22]) tensor(-2.4716) tensor([-6.7238e-01, 1.6988e-22]) tensor(-2.4716) tensor([-6.7238e-01, 5.3556e-23]) tensor(-2.4716) tensor([-6.7238e-01, 1.6884e-23]) tensor(-2.4716) tensor([-6.7238e-01, 5.3230e-24]) tensor(-2.4716)